歐盟發布《再生能源指令》相關指引,協助會員國推動再生能源電力系統整合
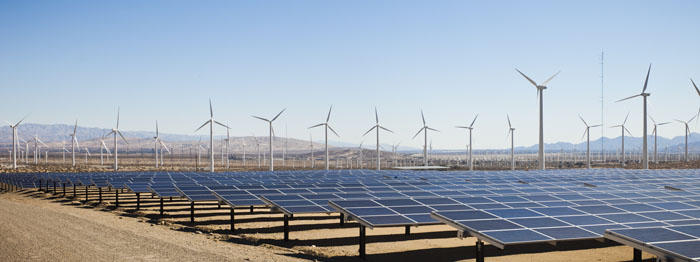
歐盟執委會(European Commission)於2024年9月2日發布「關於《2018/2001號指令》第20a條再生電力系統整合指引(經《2023/2413號指令》修訂)」(Guidance on Article 20a on sector integration of renewable electricity of Directive (EU) 2018/2001 on the promotion of energy from renewable sources, as amended by Directive (EU) 2023/2413),協助會員國落實2023年修訂版《再生能源指令》(Renewable Energy Directive, RED)第20a條,並促進再生電力系統整合。《再生能源指令》背景係為幫助歐盟達成2030年再生能源占比達45%之目標,第20a條並規範能源系統電氣化與再生能源使用。
再生電力整合指引主要涵蓋下列重點:
(1)資料共享與透明度:要求輸配電系統運營商提供再生能源比例及供應電力溫室氣體排放資料,並確保用戶能夠即時獲取相關資料。
(2)電池資訊與智慧充電:電池和電動車製造商需提供電池管理系統(Battery Management System, BMS)基本資訊,包括電池容量、充電狀態等,並推廣雙向充電技術,提升電網靈活性。
(3)電網升級與智慧電網:鼓勵會員國透過政策和獎勵措施升級智慧電網,以增強其整合再生能源之能力。指引另強調須特別注意小型分散式能源和移動式儲能系統公平進入市場之機會。
(4)跨國協作與資料可互通性(interoperability):會員國需確保系統間資料的可互通性,採用標準化資料格式,促進歐盟各國電力市場一致性與跨境合作。
根據《再生能源指令》,2025年5月前各會員國須完成第20a條內國法化相關程序。
- Guidance on Article 20a on sector integration of renewable electricity of Directive (EU) 2018/2001 on the promotion of energy from renewable sources, as amended by Directive (EU) 2023/2413
- Commission adopts guidance to EU countries on implementing the revised directives on renewable energy and on energy efficiency
- Renewable Energy Directive, European Commission
黃鈺涵
專案經理 編譯整理
Guidance on Article 20a on sector integration of renewable electricity of Directive (EU) 2018/2001 on the promotion of energy from renewable sources, as amended by Directive (EU) 2023/2413, European Commission, https://energy.ec.europa.eu/document/download/efcd200c-b9ae-4a9c-98ab-73b2fd281fcc_en?filename=C_2024_5041_1_EN_ACT_part1_v10.pdf (last visited: Oct. 1, 2024).
Commission adopts guidance to EU countries on implementing the revised directives on renewable energy and on energy efficiency, European Commission, https://energy.ec.europa.eu/news/commission-adopts-guidance-eu-countries-implementing-revised-directives-renewable-energy-and-energy-2024-09-02_en (last visited: Oct. 1, 2024).
Renewable Energy Directive, European Commission, https://energy.ec.europa.eu/topics/renewable-energy/renewable-energy-directive-targets-and-rules/renewable-energy-directive_en (last visited: Oct. 1, 2024).


日本網路安全戰略本部(サイバーセキュリティ戦略本部)於2018年7月27日發布最新3年期網路安全戰略(サイバーセキュリティ戦略),其主要目的係持續實現「提昇經濟社會活力與永續發展」、「實現國民安全且安心生活之社會」、「維持國際社會和平、安定與保障日本安全」三大目標,並透過7月25日同樣由網路安全戰略本部(サイバーセキュリティ戦略本部)發布之網路安全年度計畫2018(サイバーセキュリティ2018),執行下述資安對策的細部計畫與做法。 以下簡述依據日本三大資安目標所提出之重要資安對策: 提昇經濟社會活力與永續發展 (1) 推動可以支援創造新價值之網路安全措施。 (2) 實現可以創造價值之網路安全供應鏈。 (3) 架構安全物聯網(Internet of Things, IoT)系統。 實現國民安全且安心生活之社會 (1) 制定網路犯罪之因應對策。 (2) 官民一體共同防護關鍵基礎設施。 (3) 強化與充實政府機關之網路安全。 (4) 確保大學能建構安全與安心之教育與研究環境。 (5) 展望2020年東京奧運與未來之措施。 (6) 強化情資共享與合作體制。 (7) 強化應變大規模網路攻撃事態之能力。 維持國際社會和平、安定及保障日本安全 (1) 堅持自由、公平且安全之網路空間。 (2) 建立支配網路空間之法律秩序。 (3) 強化日本網路防禦力、抑制網路攻擊能力與掌握狀況之能力。 (4) 強化掌握網路空間狀況之能力。 (5) 國際合作。
模型內記憶化即構成重製--德國慕尼黑地方法院 判決Suno敗訴對AI訓練合理使用之衝擊模型內記憶化即構成重製--德國慕尼黑地方法院 判決Suno敗訴對AI訓練合理使用之衝擊 資訊工業策進會科技法律研究所 2026年08月24日 前言 生成式人工智慧以受著作權保護之作品為訓練資料,其行為是否構成著作權侵害、又能否主張合理使用或文字與資料探勘之限制,是人工智慧快速應用以後在著作權領域最主要的核心爭議。德國慕尼黑第一地方法院於2026年7月31日就 GEMA 控告 Suno 案作成終局判決[1],首度就生成式音樂AI的「模型內記憶化」特點給予著作權定性,並明確指出引據主張文字與資料探勘限制之適用界線。 壹、事件摘要 德國慕尼黑第一地方法院(Landgericht München I,LG München I)於2026年7月31日就德國著作權集體管理團體「音樂表演權與機械性重製權協會」(Gesellschaft für musikalische Aufführungs- und mechanische Vervielfältigungsrechte,下稱 GEMA)訴美國 AI 音樂生成器業者(被告即 Suno)案(案號42 O 763/25)作成終局判決,認定被告將受著作權保護之音樂著作「記憶化」(Memorisierung)於其模型中,構成德國著作權法(Urheberrechtsgesetz,UrhG)第16條第1項之重製,並侵害權利人之「公開再現(öffentliche Wiedergabe)」利用權[2](相當於我國著作權法上提供或傳達著作內容,包括使公眾得於其各自選定之時間或地點,以上述方法接收著作內容的公開傳輸)。 本案系爭標的為六首德語經典流行音樂:「Atemlos durch die Nacht」、「Daddy Cool」、「Rasputin」、「Big in Japan」、「Forever Young」,以及「Mambo No. 5」之副歌。原告主張,使用者僅需輸入原曲歌詞、風格或標題等簡單提示,被告之音樂生成器即會輸出與原曲高度近似之音樂[3]。法院判決被告不得以系爭音樂著作訓練模型、於模型中儲存系爭著作、在德國境內提供以系爭著作訓練之模型,以及製作侵害系爭著作之著作物[4]。本判決尚未確定,被告得提起上訴[5]。 貳、重點說明 一、模型內「記憶化」構成重製 法院認為 AI訓練依時間先後區分為三階段:抽取訓練素材並轉入機器可讀格式,即訓練資料之製作;資料之分析及以後設資訊加以增益,即模型之訓練;其後藉提示與輸出對已訓練模型之利用。整體流程依訓練性質可區分為--「僅為轉入數位格式或為分析目的而作之重製」與「留存於模型中之重製」[6]。本件關鍵在於第二階段:系爭音樂著作以可再現之方式含於模型中,其記憶化即構成著作權上相關之重製[7]。 (一)模型記憶化之概念 法院認定系爭音樂著作含於模型中,得作為輸出而被抽取,此即「記憶化」;其係指模型於訓練時,非特定之參數不僅自訓練資料集抽取資訊,且於訓練後所特定化之參數中,可見對訓練資料之完整承接(Übernahme,意指納入其中)[8]。所謂「完整」指承接超出單純資訊(如模式與相關性)之部分,非指承接之數量須完整或精確,而係至少部分地承接其內容[9]。模型自訓練資料習得統計規律,本身不受著作權法非難,然若所承接者已是著作的內容而非關於著作的資訊,性質不再只是「分析」而是「留存」 [10]。而且,被告之模型格外易受影響,特別擅長把與該提示相符之受著作權保護曲目,以極貼近原曲之方式生成為輸出[11]。換言之,使用者毋須指名要哪一首歌,只要在語音節奏上仿寫得夠像,模型即可能把原曲於輸出中再現。 法院指出記憶化判定標準因模型類型而異,有的研究要求原作與輸出內容同一,有的以部分一致為已足;就生成圖像或音訊之模型,訓練時僅抽取經選取之基礎特徵,細節資訊則被有意捨棄,故要求百分之百精確一致並不實際亦非必要。而且,模型因訓練時採「量化」(Quantisierung)而有意捨棄細節資訊,因此難以想像有一訓練資料被百分之百精確相符的記憶化,不過法院指出這些被捨棄的本就是人類感官難以掌握之細節,所以記憶化之認定應兼採「檢視旋律、節奏、和聲、識別度與風格相似值之自動檢核」及「人為評價」[12]。而記憶化的原因來自於模型自含有著作各種變體之訓練資料學習後,特定後設資料(如標題、類型或歌詞)與著作音樂特性(調性、節奏等)間之統計關聯被強化,造成使用者於提示中使用此等後設資料時,AI以所學得之統計機率導出「音樂特性大致相似」之輸出[13]。至於證明方法,法院認為訓練資料為已知時,得逕以訓練資料與輸出之比對認定;訓練資料不明時,則得借助「熵」(Entropy)與「困惑度」(Perplexity)等參數,探究模型再現一輸出之確定性[14]。 (二)記憶化之事實認定 法院以系爭著作為訓練資料一事並無爭執,而且系爭著作可藉「原歌詞、音樂風格及著作標題」之提示,明顯可辨識地再現於所提出之輸出中,認定本件記憶化已得逕以系爭音樂著作與輸出之比對認定[15] 。法院就被告之抗辯,逐一駁斥: 1. 系爭提示為簡單、開放結果之提示,輸出並非藉操控性提示所誘發:雖然被告主張原告以歷時數月、上千次、高度脈絡化之提示故意誘發記憶化,但法院認為原告固曾為3,779次提示,惟其中僅338次涉及系爭六曲;且同一提示之反覆輸入並未將輸出導向特定方向,此有別於「以評價性或暗示性指定改變脈絡」之誘發性提示[16]。 2. 系爭輸出不應歸類為偶然:鑑於所生成音樂之複雜性、長度及其與訓練資料之廣泛相符,已可排除係偶然出現的相似[17]。 3. 原告每曲僅提出一則輸出並無妨害:因為記憶化之存在,與「以不變提示是否生成同一輸出」無關[18]。 4. 無關訓練資料全部存儲可能性:雖然被告主張其模型儲存空間於數學上不足以精確儲存全部訓練資料,但法院認為重要的僅為系爭六曲是否可辨識地被記憶化[19]。 (三)記憶化含攝於著作權法之重製概念 法院就被告聲請鑑定「系爭著作是否於模型中儲存或記憶化」予以駁回,認為「權重與參數之區分於何範圍構成重製」係法律問題、非鑑定所能及[20]。法院基於下述理由認為記憶化已構成著作權法之重製: 1. 重製含「直接或間接」、「暫時或永久」及「以任何方法及任何形式」,不僅為與原件同一原樣之重製,亦包括以變更形式對著作之固著,例如類比著作之數位化、以 MP3 等壓縮檔格式之儲存,或以縮小版本之儲存[21]。 2. 因為記憶化是透過模型特定化參數中之資料,而該等參數本身又具體存於伺服器上,所以系爭著作之著作權重製要件「具體固著」。至於採何等技術固著並非決定性,模型若因訓練所導出之統計資訊而具「生成可辨識地再現該音樂著作之統計上可能詞元序列(Tokenfolgen)」之能力,即為已足[22]。 3. 固著於模型中之著作,得藉音樂生成器、一具螢幕之終端裝置及簡單、開放結果之提示,讓一般使用者以其可及之技術輔助接觸,感知並不困難。而且,重製不以可反覆之再現為前提,故認為被告要求評估的「特定輸出之機率與可反覆性」,頂多涉「是否存有記憶化」之事實問題,而非「法律意義之重製是否存在」[23]。 二、模型內重製不能主張文字與資料探勘 (一)文字與資料探勘之定義與目的拘束 法院認為「文字與資料探勘」(Text and Data Mining,TDM)係指對數位著作之自動化分析,以自其中取得特別是關於模式、趨勢與相關性之資訊[24]。而自動化分析本身並非著作權上相關之行為,蓋著作中所含非創作性之資訊本身不受保護。但因為文字與資料探勘有時須有可能侵及利用權之準備措施而涉及重製,故 TDM 的核心思想在於此等重製僅為其後分析目的而作,不損及著作人之利用利益,故人工智慧訓練為準備訓練語料之重製行為,為 TDM 所涵蓋[25];惟本案所爭執者,並非此等準備階段之重製,而是訓練後留存於模型內、並得於輸出中再現之重製[26]。 (二)記憶化逾越文字與資料探勘 法院認定系爭著作於模型中之重製並非文字與資料探勘,因為文字與資料探勘旨在抽取單純資訊,將此等資訊轉入模型參數。惟系爭著作之記憶化讓作為訓練資料之音樂著作不僅被分析,而且被承接入模型參數,並損及著作人之利用利益。因此,藉由模型記憶化所生之重製,並非「不觸及利用利益」之第一階段(製作訓練資料),文字與資料探勘限制於此不成立[27]。 (三)不得類推、無合法接觸 法院進一步排除歐盟數位單一市場著作權指令第4條[28]之類推適用,因為該條所規範的是「僅抽取單純資訊、著作本身未被重製」之情形,反之於模型內重製則使著作利用受持續損害;若類推適用,權利人將陷於無保護狀態,明顯有違該指令前言認限制對權利人所生損害僅屬「極微」之考量[29]。因此,法院進一步認為若依技術現狀無從防止訓練資料之記憶化,則以受保護資料訓練模型,即不能適用文字與資料探勘限制[30]。另外,法院亦認為本件被告係破解 Rolling Cipher 保護裝置、以串流側錄(Stream-Ripping)自 YouTube 下載系爭著作;Rolling Cipher 係為阻止下載而設,被告欠缺合法接觸,不能主張德國著作權法第44b條第2項「合法接觸」之規定[31]。 三、模型提供與生成記憶內容構成公開再現的侵害 法院認定藉模型之提供、生成音樂之應用及系爭輸出,造成權利人所享之公開再現權利受侵害[32]。 (一)公開再現之判斷標準與認定 法院指出公開再現之保護範圍,判斷標準在於著作之原創要素於另一標的中可辨識,亦即受保護著作中足以反映著作人人格之創作抉擇,是否可辨識地被承接於被指摘之標的。縱使所涉僅為著作之一小部分,只要該部分本身表達著作人自己之精神創作,即構成侵害[33]。其判斷只須以一般平均音樂聽者之聽覺理解為準[34]。 經比對譜例與聽覺印象,法院認定輸出廣泛承接六曲之旋律、作曲與編曲,各輸出均未與原曲保持充分距離。例如「Big in Japan」創意在於旋律自主歌經前副歌至副歌之三段式遞升,表達蓄積而終告釋放,同時和弦速度加快而傳遞急迫印象;AI輸出重演此整體情況,聽者因而體驗到相同之音樂起伏與情感效果[35]。 (二)被告直接為再現行為並應歸責 法院認為「再現行為」(Handlung der Wiedergabe)應不問技術手段,廣義涵蓋受保護著作之一切傳輸,故認定被告藉模型之提供及生成音樂之應用,經由使用者介面使系爭著作可被存取,模型並儲存於德國境內之邊緣伺服器,故其侵害公開再現之利用權[36]。而且只要有被存取之可能即構成,著作實際是否被存取並非所問[37]。 而且法院認被告應歸類為正犯,蓋其對藉內容輸出所為重製具行為支配(Tatherrschaft)。被告基於訓練決定輸出內容,於再現中扮演核心角色,並決定模型運作方式、訓練資料選取與訓練鋪陳,係自身為公眾開啟著作享用,非僅只是中介角色。且此等內容藉簡單提示即被再現,決定輸出具體內容的不是提示而是被告所運作之模型,被告未將行為支配給予使用者。是以,被告之模型並非僅提供「錄製私人重製所需之器械」,亦不能與不負內容責任之販售平台相比擬[38]。 基於上述理由,法院未採被告主張援引歐盟數位服務法第6條[39]的責任限制,認為該條僅限制「儲存使用者所提供資訊之中介服務」之責任,就服務提供者自身之內容並不適用。本件被告非僅提供技術中立之基礎設施,而係提供模型並製作系爭輸出,其前之提示簡單且未於內容上指定或誘發,故各輸出為被告自身之資訊,就此其扮演主動角色,而非被動中介之外來資訊[40]。 四、合理使用抗辯不成立 針對被告在美國境內之訓練行為,法院依美國著作權法(17 U.S.C.)審酌是否構成合理使用(Fair Use),認為四項因素綜合觀之均不利於被告[41]: (一)利用之目的與性質 本件被告之應用並未生成新音樂著作,而係生成與訓練所用系爭著作實質相似之錄音,音樂著作並未被轉化[42]。被告之利用亦為商業性利用,其重製與原作追求相同的目的[43]。法院並將被告規避 Rolling Cipher、以串流側錄取得訓練資料一節,評價為惡意而顯著不利於被告[44]。 (二)著作之性質 系爭音樂著作為涉著作權核心之創意著作,被告所製作之音樂非僅承接概念,而係承接系爭曲之創意要素,故非如逆向工程般僅為研究功能而重製[45]。 (三)所利用之質量 被告為訓練其模型而對系爭音樂著作為廣泛重製,且未闡明其何以必須依賴此等廣泛重製。法院指出於大量重製之情形,關鍵在於所重製之著作係向公眾提供,抑或僅參與技術上不可見之後端程序;本件與 Google Books 案顯著不同,該案被告並未將重製向公眾提供[46]。 (四)對潛在市場或價值之影響 法院認為訓練所生之輸出構成取代原作之替代物,在「使用者直接消費之娛樂音樂」市場與原作競爭[47]。被告抗辯系爭輸出係在同一提示反覆輸入多次之後才出現,故不足以認定市場影響;而且第四項因素不僅看具體侵害行為之影響,還要看此類利用行為一般而言是否可能對原作市場產生顯著負面效果。本件原告就各曲分別輸入4至176則相同提示始取得系爭輸出,惟被告之音樂生成器於2024年單一月份即錄得220萬名訪客,以此流行程度計,縱使平均每4次或每176次輸入才得到一個與原作實質相似之音樂,累積於市場上之替代效果仍屬顯著[48]。 法院特別強調本件輸入僅含歌詞之提示後生成實質相似輸出,與美國 Bartz、Kadrey 兩案顯著不同,該兩案中訓練資料未實質於輸出中讓使用者可觸及,未因生成實質相似輸出而明顯可看到對市場的影響[49]。權衡一切因素,法院認被告之具體利用不為合理使用所涵蓋,且並非所有模型均記憶化其訓練資料,故於本案件否定合理使用既不妨礙進步或競爭,亦不牴觸模型之發展公益[50]。 參、事件評析 本案立於歐盟資訊社會著作權指令與數位單一市場著作權指令所建構之重製權與文字與資料探勘體系,其「公開再現」與我國由公開播送、公開演出、公開傳輸等權能概念亦並不全等同,而其本身能否維持猶待上訴審檢驗,亦有待後續觀察。但本案的重點在於,把過去類似爭議的爭訟焦點由「訓練是否構成重製」展開為「模型是否留存並於輸出中再現受保護著作」,並進一步加重AI開發與服務提供者被歸責可能性,本文認為可歸納其重點如下: 一、法院未全面否定訓練之資料取用可主張合理使用,但前提須為合法取得 本判決雖判被告不得援引合理使用,惟其論證重心並不在「以受保護著作訓練模型」這件事本身。法院明白表示訓練一個能生成新音樂作品的模型,一般而言確實可能是具轉化性、追求更進一步目的而為合理使用所涵蓋之利用。本案之所以認定不同,是被告之應用並未生成新的音樂作品,而係以系爭輸出生成與訓練所用著作實質相似之錄音,音樂著作因而未受轉化。法院於綜合權衡時亦明言,並非所有模型都會記憶其訓練資料,於本案否定合理使用既不妨礙進步與競爭,也不牴觸公共利益,蓋須取得授權不等於不能訓練。因此,本判決所否定的是「訓練後留存於模型、並得於輸出中再現」,而非概括否定 AI 訓練之資料取得有主張合理使用之餘地。但法院對被告規避 Rolling Cipher、以串流側錄取得訓練資料一節評價為惡意,顯示取得手段是否合法,從目前國際上的司法案例看來,仍是決定是否能主張合理使用的重要環節。 二、能否主張合理使用或文字與資料探勘,取決於一般提示下是否再現實質近似內容 法院認定本案與美國 Bartz、Kadrey 二案顯著不同,關鍵在於本案訓練資料實質地在使用者僅輸入歌詞、未作任何音樂上要求之簡單且結果開放之提示下,即可生成與原曲實質相似之輸出。而文字與資料探勘之審酌,法院並不否認為準備訓練語料所為之第一階段重製落入德國著作權法第44b條範圍,真正逾越限制者是第二階段留存於模型內之記憶化。是以,若訓練所得之模型不會在一般、未經特別設計引導之提示下再現實質近似之內容,主張文字與資料探勘限制或合理使用仍有空間。而且必須注意的是,倘依技術現狀無從防止訓練資料之記憶化,法院認為將受保護資料訓練模型即不為該限制所涵蓋,則「能否防止記憶化」就是AI開發與服務業者重要的技術降險研發重點。 三、AI記憶化的輸出由模型提供者承擔侵權責任 本判決外溢效果最大者為責任歸屬,法院認定AI記憶化的輸出產生的再現行為,是源自於被告以模型與使用者介面,開啟讓公眾對已記憶化著作可存取。就輸出所生之重製,被告因對模型架構、訓練資料選取與訓練設計負責而具行為支配,應歸類為正犯;僅輸入提示觸發生成之使用者,不被視為重製行為人。顯見有關AI責任的認定,法院著重於誰對於結果具有實質主導的控制能力,AI 服務提供者將來可能更難以主張模型只是提供「工具」、由使用者決定產出,也不能主張自己是中立平台而把使用責任歸予使用者。 本案法院判決提出的模型記憶化(留存受保護著作)構成重製的觀點,其重點在於一定程度緩解權利人的內容再現舉證困難,並透過受訓練資料與特徵近似的生成結果判斷記憶化的存在,進一步認定存在重製結果,而且該重製欠缺轉化性、具商業目的、結果對權利人市場造成明顯負面影響。我國對於AI 訓練是否合法的認定,仰賴著作權法第65條合理使用之一般條款判斷,雖須個案、事後之權衡,但從本案法院見解可見,避免AI的記憶與所記憶內容的出現是關鍵點,如技術上可能,業者須溯源在訓練過程採取去記憶化的事前避險措施,以避免成為記憶內容之提供者而須自行承責。 本文著作權屬財團法人資訊工業策進會科技法律研究所所有,如需引用或轉載,請註明出處。 本文同步刊登於TIPS網站(https://www.tips.org.tw) [1]LG München I, Endurteil vom 31.07.2026, Az. 42 O 763/25。 [2]Id., Rn. 239, 262, 317, 375. [3]Id., Rn. 4, 26. [4]Id., Urteilstenor Nr. 1 a) aa), a) bb), b), c). 原告依德國著作權法第19a條公開提供權所為之聲明則遭駁回,法院認一次調取至多需輸入176個相同提示,該調取非於使用者所選定之時間發生;其餘之訴亦經駁回。Rn. 315, 316, 554. [5]Landgericht München I, Pressemitteilung vom 31.07.2026, https://www.justiz.bayern.de/gerichte-und-behoerden/landgericht/muenchen-1/presse/2026/16.php (last visited Aug. 21, 2026). [6]LG München I, supra note 1, Rn. 240. [7]Id., Rn. 241. [8]Id., Rn. 243. [9]Id. [10]Id., Rn. 240, 243, 283, 294. [11]Id., Rn. 244. [12]Id., Rn. 245. [13]Id., Rn. 246. [14]Id., Rn. 247. [15]Id., Rn. 249. [16]Id., Rn. 250-253. [17]Id., Rn. 258. [18]Id., Rn. 259. [19]Id., Rn. 260. [20]Id., Rn. 261. [21]Id., Rn. 263, 264. [22]Id., Rn. 268-270. [23]Id., Rn. 276-279. [24]Id., Rn. 283. [25]Id., Rn. 284, 285. [26]Id., Rn. 289, 293. [27]Id., Rn. 294, 295. [28]Directive (EU) 2019/790 of the European Parliament and of the Council of 17 April 2019 on copyright and related rights in the Digital Single Market and amending Directives 96/9/EC and 2001/29/EC, art. 4, 2019 O.J. (L 130) 92. [29]LG München I, supra note 1, Rn. 299. [30]Id., Rn. 304. [31]Id., Rn. 13, 308, 310. [32]Id., Rn. 317. [33]Id., Rn. 321. [34]Id., Rn. 323. [35]Id., Rn. 197, 349. [36]Id., Rn. 373, 374. [37]Id., Rn. 375, 376. [38]Id., Rn. 399-401. [39]Regulation (EU) 2022/2065 of the European Parliament and of the Council of 19 October 2022 on a Single Market For Digital Services and amending Directive 2000/31/EC (Digital Services Act), art. 6, 2022 O.J. (L 277) 1. [40]LG München I, supra note 1, Rn. 408, 409. [41]Id., Rn. 447-449. [42]Id., Rn. 484-486, 493, 494. [43]Id., Rn. 498-500. [44]Id., Rn. 504-510. [45]Id., Rn. 511, 512. [46]Id., Rn. 514-518. [47]Id., Rn. 519-523. [48]Id., Rn. 27, 492, 527. [49]Id., Rn. 480, 526. [50]Id., Rn. 530, 531.
日本將數位廣告業者列入特定數位平台之透明性及公正性提升法適用對象日本於2022年7月5日閣議決定修正政令將數位廣告(デジタル広告)的大型數位平台(デジタルプラットフォーム)業者列入「特定數位平台之透明性及公正性提升法」(特定デジタルプラットフォームの透明性及び公正性の向上に関する法律)適用對象,修正政令於2022年7月8日正式公布,並預計自2022年8月1日開始施行。 日本於2020年5月27日通過特定數位平台之透明性及公正性提升法(以下簡稱本法),要求特定數位平台業者公開提供服務條件,主動積極採取因應措施並進行自我評估,以提升特定數位平台透明性與公正性,促進國民經濟健全發展。隨著數位平台重要度與日俱增,數位廣告的數位平台企業影響力亦逐漸擴大,甚至將對媒體事業收益結構帶來重大改變。日本於2021年6月18日閣議決定「2021經濟財政營運及改革基本方針」(経済財政運営と改革の基本方針2021)與「成長戰略實行計畫」(成長戦略実行計画),均提出須關注數位市場競爭環境,因應新時代統整數位廣告市場規則,將數位廣告的大型數位平台業者列入本法適用對象,整合數位平台透明性與公平性規則。 本次修正政令列入本法適用對象的數位廣告業者包含:一、日本國內營業額在1000億日圓以上的媒體整合型廣告數位平台。二、日本國內營業額在500億日圓以上的廣告仲介型數位平台。日本期望能藉由統整數位廣告市場規則,解決數位廣告市場的垂直整合問題,同時強化消費者隱私保護。
法國資料保護機關要求Clearview AI刪除非法蒐集的個人資料法國國家資訊自由委員會(Commission nationale de l’informatique et des libertés, CNIL)自2020年5月起陸續收到民眾對臉部辨識軟體公司Clearview AI的投訴,並展開調查。嗣後,CNIL於2021年12月16公布調查結果,認為Clearview AI公司蒐集及使用生物特徵識別資料(biometric data)的行為,違反《一般資料保護規範》(General Data Protection Regulation,GDPR)的規定,分別為: 非法處理個人資料:個人資料的處理必須符合GDPR第6條所列舉之任一法律依據,始得合法。Clearview AI公司從社群網路蒐集大量全球公民的照片與影音資料,並用於臉部辨識軟體的開發,其過程皆未取得當事人之同意,故缺乏個人資料處理的合法性依據。 欠缺保障個資主體的權利:Clearview AI公司未考慮到GDPR第12條、第15條及第17條個資主體權利之行使,特別是資料查閱權,並且忽視當事人的個資刪除請求。 因此,CNIL要求Clearview AI公司必須於兩個月內改善上述違法狀態,包括:(1)在沒有法律依據的情況下,停止蒐集及使用法國人民的個資;(2)促進個資主體行使其權利,並落實個資刪除之請求。若Clearview AI公司未能於此期限內向CNIL提交法令遵循之證明,則CNIL可依據GDPR進行裁罰,可處以最高 2000萬歐元的罰鍰,或公司全球年收入的4%。